먼저 잡을 핵심
- 모집단 분산과 통상적인 표본분산은 분모가 다르므로 계산 목적을 먼저 읽습니다.
- 분산은 원래 단위의 제곱이고 표준편차는 원래 단위입니다.
- 표준화는 분포 모양을 정규분포로 만들지 않으며 평가 자료로 변환 기준을 학습하지 않습니다.
평균이 같아도 자료의 모습은 다릅니다
예제 A의 값은 4, 5, 6이고 예제 B의 값은 1, 5, 9입니다. 두 자료의 평균은 5입니다. A는 평균에서 멀어야 1만큼 떨어져 있지만 B는 4만큼 떨어집니다. 평균만으로는 이 차이를 설명할 수 없어 산포, 곧 값이 퍼진 정도를 계산합니다.
각 값에서 평균을 뺀 수를 편차라고 합니다. A의 편차는 −1, 0, 1이고 B의 편차는 −4, 0, 4입니다. 두 자료 모두 편차의 합은 0이므로 편차를 그대로 평균 내면 퍼짐이 사라집니다. 양수와 음수가 상쇄되지 않도록 편차를 제곱한 뒤 합하는 것이 분산 계산의 출발점입니다.
A의 편차 제곱합은 1 + 0 + 1 = 2이고 B는 16 + 0 + 16 = 32입니다. 같은 기준으로 나누면 B의 분산이 A의 16배입니다. 표준편차는 분산의 제곱근이므로 B가 A의 4배가 됩니다. 원래 값의 평균으로 나누는 것이 아니라 자료 개수 또는 자유도에 맞춰 나눈다는 점을 구분하세요.
분모를 고르는 질문은 계산 전에 합니다
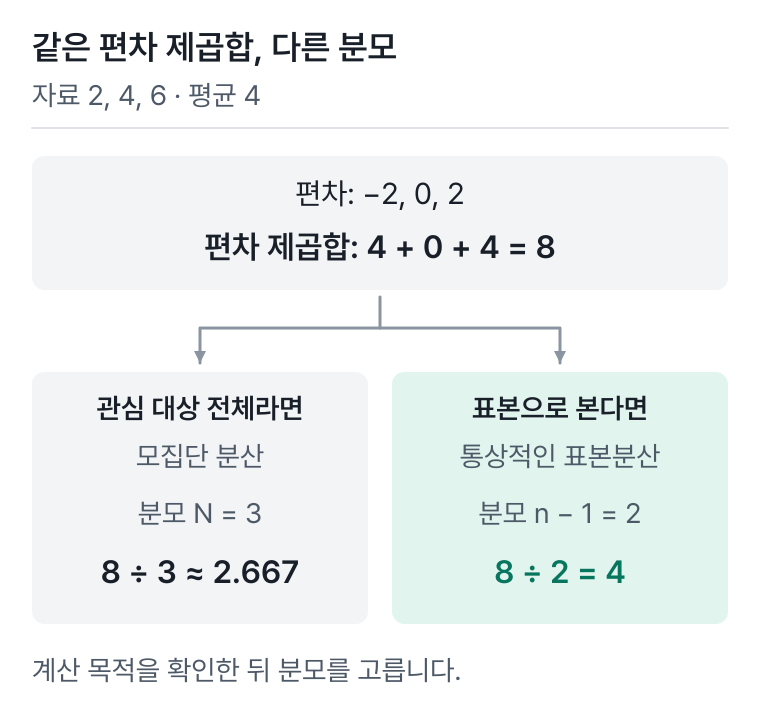
현재 가진 값이 관심 대상 전체인 모집단이면, 모집단 분산은 편차 제곱합을 전체 개수 N으로 나눕니다. 반대로 표본을 보고 더 큰 모집단의 분산을 추정하는 통상적인 표본분산은 n−1로 나눕니다. 시험에서는 문제에 모집단, 표본, 불편분산 중 어떤 표현이 있는지 먼저 읽는 것이 안전합니다.
자료 2, 4, 6의 평균은 4이고 편차 제곱합은 4 + 0 + 4 = 8입니다. 세 개가 관심 대상 전체라면 분산은 8 ÷ 3이며 약 2.667입니다. 같은 세 값을 표본으로 취급한 표본분산은 8 ÷ 2 = 4입니다. 표본표준편차는 √4 = 2가 됩니다. 원자료가 같아도 계산 목적이 다르면 분모가 달라집니다.
표본에서 평균을 계산하면 편차 n개 중 하나는 나머지 편차가 정해지는 순간 함께 정해집니다. 편차 합이 0이어야 하기 때문입니다. 이 제약을 자유도 n−1과 연결해 이해할 수 있습니다. 독립적이고 같은 분포에서 뽑힌 관측값에 대해 n−1로 나누는 표본분산은 모집단 분산의 불편추정량입니다. 표본표준편차까지 곧바로 불편추정량이라고 확장하면 틀립니다.
| 계산 목적 | 편차 제곱합을 나누는 수 | 2, 4, 6의 결과 |
|---|---|---|
| 주어진 전체 자료의 모집단 분산 | 3 | 8/3 |
| 모집단 분산을 추정하는 표본분산 | 2 | 4 |
| 표본표준편차 | 표본분산의 제곱근 | 2 |
표준편차가 원래 단위로 돌아오는 이유
대기 시간을 분 단위로 측정했다면 분산의 단위는 분의 제곱입니다. 제곱근을 취한 표준편차의 단위는 다시 분이 됩니다. 그래서 보고서에서는 표준편차를 원래 값의 크기와 함께 읽기 쉽습니다. 다만 표준편차가 평균적인 절대 거리와 정확히 같다는 설명은 피해야 합니다. 편차를 제곱하고 평균한 뒤 제곱근을 취하는 계산과 절댓값의 평균은 다릅니다.
모든 값에 10을 더하면 평균은 10 증가하지만 값 사이의 간격은 그대로입니다. 분산과 표준편차도 변하지 않습니다. 모든 값에 3을 곱하면 편차도 3배가 되므로 분산은 9배, 표준편차는 3배가 됩니다. 음수를 곱하더라도 표준편차는 음수가 되지 않습니다. 곱한 수의 절댓값만큼 변합니다.
이 성질은 단위를 바꿀 때 유용합니다. 분을 초로 바꾸려고 60을 곱하면 표준편차도 60배가 되며 분산은 3,600배가 됩니다. 표준편차 수치만 보고 두 자료 중 어느 쪽이 더 불안정한지 비교하기 전에 단위가 같은지부터 봐야 합니다.
표준화는 정규분포를 만드는 작업이 아닙니다
표준화 점수 z는 값에서 기준 평균을 빼고 기준 표준편차로 나눠 계산합니다. 평균이 70이고 표준편차가 10인 점수에서 85의 z값은 (85 − 70) ÷ 10 = 1.5입니다. 기준 평균보다 표준편차의 1.5배만큼 위에 있다는 설명입니다. 이것만으로 상위 몇 퍼센트인지 정확히 알 수는 없습니다. 백분위로 바꾸려면 분포에 관한 정보가 더 필요합니다.
표준편차가 0이 아닌 자료를 그 자료의 평균과 표준편차로 변환하면, 같은 분산 계산 기준에서 평균 0과 분산 1을 얻습니다. 그 기준으로 바꾼 새로운 자료까지 평균 0과 분산 1이 되는 것은 아닙니다. 이런 변환을 하더라도 자료의 비대칭이나 이상치가 사라지지는 않습니다. 한쪽으로 길게 늘어진 원자료는 선형 표준화 후에도 같은 방향으로 늘어져 있습니다. 표준화와 정규분포로의 변환을 같은 뜻으로 쓰지 않는 이유입니다. 표준편차가 0인 상수 변수는 나눗셈이 정의되지 않으므로 별도 처리가 필요합니다.
도구의 계산 관례도 확인합니다. R의 var 함수는 n−1을 분모로 사용하지만, scikit-learn의 StandardScaler는 표준편차를 구할 때 n을 사용하는 방식입니다. 서로 다른 도구의 결과가 약간 다르다고 바로 오류로 판단하면 안 됩니다. 시험 계산에서는 제시된 정의를, 실습에서는 사용한 함수의 문서를 따르세요.
퍼짐을 계산할 때는 분모와 단위를 같이 복원합니다
제곱해 상쇄를 막고, 목적에 맞게 나눈 뒤, 제곱근으로 단위를 되돌립니다. 편차를 그대로 더하면 0이 되는 이유에서 제곱을 떠올리고, 구하려는 것이 분산인지 표준편차인지 단위로 확인하는 순서입니다. 분산은 원래 단위의 제곱이고 표준편차는 원래 단위입니다.
분모는 이 문장만으로 결정되지 않습니다. 전체의 퍼짐을 계산하면 N, 표본으로 모집단 분산을 불편추정하는 통상적 계산이면 n−1입니다. 표본평균을 사용해 편차 합이 0이 되는 제약을 n−1과 연결하세요. n−1로 나눴다는 사실이 작은 표본의 추정을 항상 정확하게 만들거나 표준편차까지 불편추정량으로 만드는 것은 아닙니다.
예측 모델에서는 변환 기준도 학습 대상입니다
훈련 데이터의 평균이 50, 표준편차가 10이라고 가정합니다. 검증 데이터의 새 값 70을 바꿀 때는 훈련 데이터에서 정한 기준을 그대로 사용해 z = 2로 계산합니다. 검증 데이터까지 합쳐 평균과 표준편차를 다시 계산하면 아직 보지 않아야 할 평가 자료의 정보가 변환에 들어갑니다. 이런 유입을 데이터 누수라고 합니다.
표준화가 모든 모델에서 똑같이 필요한 것은 아닙니다. 거리로 이웃을 찾거나 변수의 크기에 민감한 계산에서는 단위가 큰 변수가 결과를 좌우할 수 있습니다. 반면 변수별 기준값으로 분할하는 결정트리는 일반적인 양의 선형 스케일 변환에 비교적 영향을 덜 받습니다. 무조건 표준화를 한다고 외우기보다 모델이 무엇을 계산하는지 연결해 보세요.
복습 순서는 원자료, 평균, 편차, 편차 제곱합, 분모, 제곱근으로 잡으면 됩니다. 마지막에 단위를 적으면 분산과 표준편차를 혼동했는지도 확인할 수 있습니다. 아래 확인 문제는 공식 기출문제가 아닌 자체 학습 문제입니다.
놓치기 쉬운 지점
- 표본분산이 불편추정량이라는 설명을 표본표준편차에도 그대로 적용하는 실수
- 전체 데이터로 표준화한 뒤 훈련·검증 자료를 나누는 실수
스스로 확인하기
- 모집단인지 표본인지 문제의 조건에 표시한다.
- 편차 제곱합과 최종 분모를 따로 적는다.
- 모델 평가에서는 훈련 데이터로 계산한 변환 기준을 재사용한다.
아래 질문은 개념 확인을 위해 작성한 학습용 문항입니다. 공식 기출문제가 아닙니다.
Q1. 표본 1, 3, 5의 표본분산과 표본표준편차를 구하세요.
생각한 뒤 해설 보기
평균은 3, 편차 제곱합은 8입니다. 표본분산은 8/(3−1)=4, 표본표준편차는 2입니다.
Q2. 모든 관측값을 2배로 늘리면 분산은 몇 배가 되나요?
생각한 뒤 해설 보기
편차도 2배이므로 분산은 4배입니다. 표준편차는 2배입니다.
Q3. z값이 2이면 자료가 반드시 정규분포이고 상위 약 2.3%라고 말할 수 있나요?
생각한 뒤 해설 보기
아니요. z값은 평균에서 표준편차 두 배 위라는 상대 위치입니다. 정규분포 가정을 확인하지 않고 정규분포의 누적확률을 적용할 수 없습니다.
Q4. 표본 10, 14로 모집단 분산을 불편추정합니다. 평균, 편차 제곱합, 표본분산, 표본표준편차를 구하세요.
생각한 뒤 해설 보기
평균은 12이고 편차 제곱합은 4+4=8입니다. 표본분산은 8/(2−1)=8, 표본표준편차는 √8로 약 2.828입니다. 두 값이 모집단 전체라면 모집단 분산은 8/2=4이므로 계산 목적을 구분합니다.
Q5. 모든 관측값을 y=10−2x로 바꿨습니다. 원래 표준편차가 3이면 새 표준편차는 −6인가요?
생각한 뒤 해설 보기
아닙니다. 더한 10은 퍼짐을 바꾸지 않고 곱한 −2는 간격을 절댓값 2배로 만듭니다. 새 표준편차는 6, 새 분산은 36입니다. 원래 분산 9의 4배입니다.
이 개념의 객관식 연습
더 궁금한 점
표본이 하나일 때 표본분산은 얼마인가요?
n−1이 0이 되므로 통상적인 표본분산은 계산할 수 없습니다. R의 var 함수도 관측값이 하나이면 NA를 반환합니다. 이를 분산 0과 혼동하지 않습니다.
표준편차가 크면 항상 자료 품질이 나쁜가요?
아닙니다. 실제 대상이 다양하면 퍼짐이 큰 것이 자연스럽습니다. 입력 오류, 측정 단위, 조사 대상의 차이를 확인한 뒤 품질 문제인지 판단합니다.
참고한 자료와 확인 범위
- NIST 산포 통계량 설명 ↗
분산과 표준편차의 정의를 확인했습니다.
- R의 분산·공분산·상관계수 문서 ↗
var 함수의 n−1 분모와 관측값 하나일 때의 처리를 확인했습니다.
- scikit-learn StandardScaler 문서 ↗
표준화 식과 분산 계산 관례를 확인했습니다.
- scikit-learn 데이터 누수 안내 ↗
훈련 데이터에서 변환을 학습하고 평가 데이터에는 같은 변환을 적용하는 원칙을 확인했습니다.
예제 수치와 질문은 학습 목적으로 구성했습니다. 시험 운영 정보는 공식 공지를 우선합니다.
이 글은 입문자 기준으로 정리했습니다. 계산이나 설명의 오류를 발견하면 이 글의 오류 제보를 보내주세요. 내용을 보완할 때 수정일도 함께 갱신합니다.